5,000개 파일을 원자적으로 배포하기: Atomic Rename 패턴과 SeaweedFS 아키텍처
한 줄 요약: "데이터를 움직이지 말고, 데이터를 가리키는 포인터를 움직여라"
올해 3D 타일 배포 파이프라인을 새롭게 구축했습니다.
빌드 한 번에 최대 5,000개의 파일이 생성되고, 이런 빌드 결과물이 수십 회 이상 누적되어 하나의 배포 버전을 이룹니다. 가장 큰 기술적 난제는 물리적으로 분리된 DB(상태)와 오브젝트 스토리지(파일) 사이의 정합성 유지였습니다. 업로드 도중 장애가 발생하면, 스토리지에는 파일이 올라갔는데 DB에는 실패로 기록되는 — 두 시스템 간 상태 불일치가 언제든 일어날 수 있었습니다.
복잡하고 성능에 불리한 2PC(Two-Phase Commit) 대신, Atomic Rename 패턴을 적용하여 이 문제를 해결했습니다. 완성된 데이터를 스테이징 경로에 먼저 격리한 뒤, 배포 시점에 공개 경로로 원자적으로 전환하는 전략입니다.
이를 통해 부분 반영(Partial Update)을 원천 차단하고, 서비스가 항상 완전한 데이터 세트만 서빙하도록 보장했습니다.
이 글에서는 해당 아키텍처를 SeaweedFS와 결합하여 효율적으로 Atomic Switch를 구현한 과정을 정리합니다.
참고
SeaweedFS GitHub
목차
- 문제 정의
- 해결책: Atomic Rename 패턴
- 구현 제약 조건: S3 호환 스토리지의 한계
- 최적화: Metadata-only Rename (SeaweedFS 도입)
- 요약
1. 문제 정의
1.1 시스템 요구사항
단일 Job 수행 시, 최대 5,000개의 파일을오브젝트 스토리지에 적재하고 동시에 관계형 데이터베이스에 메타데이터를 반영해야 합니다. 이 프로세스는 일일 최대 1,000회 발생하며, 다음 두 가지 정합성 요구사항을 만족해야 합니다.
- 원자성(Atomicity): '5,000개 파일의 스토리지 적재'와 'DB 상태 갱신'은 하나의 논리적 단위로 처리되어야 합니다. All-or-Nothing입니다.
- 부분 실패 허용 불가: 5,000개 중 단 하나의 파일이라도 업로드에 실패하면, 전체 Job은 실패로 간주되어야 합니다.
1.2 문제 상황: 분산 환경의 Dual Write
오브젝트 스토리지(비정형 데이터)와 관계형 데이터베이스(정형 메타데이터)는 물리적으로 분리된 이종 시스템입니다. 별도의 분산 트랜잭션 코디네이터 없이 이 두 시스템의 상태를 동기화하는 것은 전형적인 Dual Write 문제입니다.
단순하게 '파일 업로드 → DB 업데이트' 순서로 구현하면, 다음과 같은 엔지니어링 이슈에 직면합니다.
1) Long-running Transaction과 리소스 고갈
가장 직관적인 구현은 DB 트랜잭션을 열어둔 채 파일을 업로드하는 것입니다. 하지만 이는 DB 아키텍처 관점에서 명백한 안티 패턴입니다.
- Connection Pool Starvation: 5,000개 파일을 업로드하는 수십 초~수 분 동안 DB 커넥션이 Idle 상태로 점유됩니다.
- Throughput 저하: 피크 타임에 Job이 몰리면 커넥션 풀이 고갈됩니다. 로그인이나 조회 같은 단순 트랜잭션까지 타임아웃이 발생하고, 전체 서비스 장애(Outage)로 확산될 수 있습니다.
2) 정합성 불일치와 고아 파일(Orphaned Objects)
업로드 로직 완료와 DB 커밋 사이에는 필연적으로 시간차가 존재합니다.
- 시나리오: 파일 5,000개 업로드는 성공했으나, 네트워크 단절이나 애플리케이션 Restart로 인해 DB Commit이 실행되지 못한 경우.
- 결과: 스토리지에는 과금되고 공간을 차지하는 파일이 존재하지만, DB에는 기록이 없어 애플리케이션이 접근할 수 없는 고아 파일(Orphan Files)이 누적됩니다. 이를 해소하려면 별도의 주기적 GC(Garbage Collection) 프로세스가 필요하고, 운영 복잡도가 증가합니다.
3) 부분 실패(Partial Failure)와 멱등성(Idempotency) 위반
분산 시스템에서 가장 까다로운 것은 '실패'가 아니라 '애매한 상태(Undetermined State)'입니다.
- 재시도의 모호함: 5,000개 중 2,500번째 파일에서 타임아웃이 발생했다면, 재시도 시 처음부터 다시 덮어써야 할까요? 나머지 2,500개만 이어서 올려야 할까요?
- 경쟁 상황(Race Condition): 재시도 프로세스가 돌고 있는 도중 사용자가 불완전한 파일 세트를 조회하면, 깨진 데이터를 제공할 위험이 있습니다.
결론적으로, 스토리지 업로드 완료 시점과 데이터 노출 시점을 원자적으로 동기화할 결정적(Deterministic) 메커니즘이 없으면 시스템의 신뢰성을 보장할 수 없습니다.
2. 해결책: Atomic Rename 패턴
파일 시스템의 Atomic Rename(원자적 이름 변경) 특성을 분산 스토리지에 적용하여 이 문제를 해결했습니다.
핵심 원칙은 명확합니다.
"업로드가 완전히 검증되기 전까지는, 그 누구도 해당 파일에 접근할 수 없어야 한다." — Isolation
2.1 프로세스 아키텍처
데이터 처리 과정을 업로드(임시 저장) → 검증(정상 여부 확인) → 반영(Commit)의 3단계 파이프라인으로 분리하여 상태 관리를 명확히 했습니다.
1단계: 업로드 — 임시 경로에 격리
모든 파일은 실제 서비스에 노출되는 경로가 아닌, 임시 폴더에 먼저 저장됩니다.
/temp/{작업ID}/tile_0001.glb
/temp/{작업ID}/tile_0002.glb
...
/temp/{작업ID}/tile_5000.glb
이 단계에서는 파일이 몇 천 개가 업로드되더라도, 사용자가 접근하는 서비스 경로에는 아무런 변화가 없습니다. 업로드 도중이거나 일부만 올라간 상태가 외부에 노출되는 일은 없습니다.
2단계: 검증 — 정합성 확인
임시 폴더에 업로드된 파일의 개수, 크기, 손상 여부를 일괄 검증합니다.
만약 단 하나라도 문제가 발견되면, 임시 폴더(/temp/{작업ID}/)를 그대로 삭제하면 끝입니다. 서비스에는 아무것도 반영되지 않았기 때문에, 되돌리기(Rollback)를 위한 복잡한 보상 로직이 필요하지 않습니다.
3단계: 반영 — Atomic Commit
모든 검증이 끝나면, 임시 폴더를 실제 서비스 폴더로 한 번에 이름만 변경합니다.
/temp/{작업ID}/ → /production/{작업ID}/이 폴더 Rename이 곧 "반영 완료" 시점입니다. 이 순간부터 모든 파일이 한꺼번에 서비스에 노출되기 시작합니다. 중간 상태는 존재하지 않습니다.
2.2 대안 분석: 로컬 버퍼링 방식과의 비교
이 구조를 확정하기 전, 초기에는 로컬 버퍼링(Local Buffering) 방식을 검토했습니다. 파일을 즉시 스토리지로 보내지 않고, 애플리케이션 서버의 로컬 디스크에 임시로 쌓아두었다가 완료 시점에 일괄 업로드하는 방식입니다.
직관적이지만, 치명적인 약점이 있었습니다.
| 비교 항목 | A안: 로컬 버퍼링 후 Bulk 업로드 | B안: Remote Temp 후 Atomic Rename ✅ |
| 상태 관리 | Stateful — 서버가 파일 상태를 보유 | Stateless — 모든 상태를 스토리지에 위임 |
| 장애 영향 | 서버 Crash 시 로컬 파일 전량 유실, 복구 불가 | 서버가 죽어도 파일은 스토리지 /temp에 안전. 다른 서버가 이어받기 가능 |
| 확장성 | 서버 디스크 용량 한계. 오토스케일링 시 동기화 복잡 | 서버는 중계 역할만 수행. 수평 확장에 유리 |
| 결론 | 부적합 (데이터 유실 위험, 복구 비용 높음) | 적합 (원자성 보장, 멱등성 확보, 운영 용이) |
핵심적인 차이는 상태의 소유권입니다. A안은 애플리케이션 서버가 상태를 가집니다. 서버가 죽으면 데이터도 같이 사라집니다. B안은 스토리지가 상태를 가집니다. 서버는 언제든 교체 가능한 무상태(Stateless) 워커가 됩니다. 분산 시스템에서 "상태를 가진 노드는 장애에 취약하다"는 원칙을 그대로 따른 선택이었습니다.
Note: 메타데이터 저장소 선정 — Redis vs PostgreSQL
SeaweedFS의 메타데이터를 관리하는 Filer Store로 Redis와 PostgreSQL을 검토했습니다. 결론적으로 PostgreSQL을 선택했는데, 인메모리 스토어(Redis)의 속도보다는 ACID 트랜잭션 보장과 지속성(Durability)이 메타데이터 관리에서 더 중요하다고 판단했기 때문입니다. Atomic Rename의 정합성은 메타데이터 저장소의 트랜잭션 보장에 직접 의존하므로, 이 선택은 아키텍처의 핵심 전제이기도 합니다.
3. 구현 제약 조건: S3 호환 스토리지의 한계
Atomic Rename 패턴은 논리적으로 완벽합니다. 하지만 막상 구현 단계에서 벽에 부딪혔습니다. AWS S3나 MinIO 같은 표준 오브젝트 스토리지에서는 Rename이 매우 비싼 연산이기 때문입니다.
3.1 Copy-Delete 메커니즘의 오버헤드
대부분의 오브젝트 스토리지는 객체의 불변성(Immutability)을 전제로 설계되어 있습니다. 파일 시스템의 mv 명령어처럼 네이티브 Rename을 지원하지 않습니다.
S3 API에서 Rename은 내부적으로 CopyObject + DeleteObject의 조합으로 수행됩니다. 이름만 바꾸는 것이 아니라, 물리적으로 데이터를 복사한 뒤 원본을 삭제하는 것입니다.
- 시간 복잡도: O(N) — 데이터 크기와 개수에 비례
- I/O Cost: 5,000개 파일 Rename 시, 5,000번의 물리적 데이터 복사 + 5,000번의 삭제가 발생
설계 단계에서 구상한 "ms 단위의 원자적 전환"은 S3 호환 스토리지에서는 불가능했습니다. 이 문제를 해결할 수 있는 스토리지 엔진이 필요했습니다.
4. 최적화: Metadata-only Rename과 SeaweedFS 아키텍처
데이터 이동 없이 메타데이터 수정만으로 O(1) Rename을 구현하기 위해, SeaweedFS를 스토리지 엔진으로 채택했습니다. 왜 SeaweedFS에서 이것이 가능한지 이해하려면, 먼저 이 시스템의 아키텍처를 살펴볼 필요가 있습니다.
4.1 SeaweedFS의 핵심 구성요소
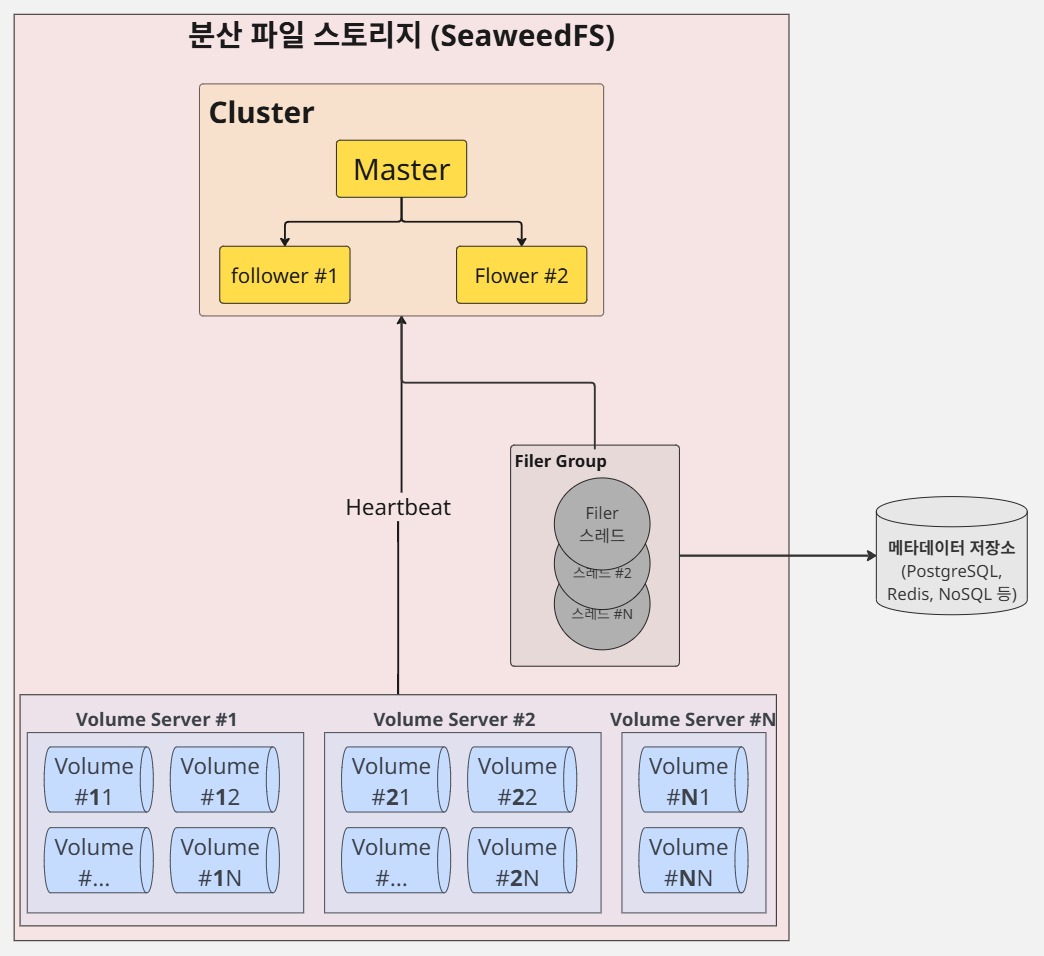
Master Server — 클러스터의 두뇌
Master Server는 클러스터 전체를 관장하는 코디네이터입니다. Volume Server들의 상태를 모니터링하고, 새 파일이 업로드될 때 어떤 Volume에 저장할지 할당(Assignment)합니다. 또한 Volume의 복제(Replication) 전략을 관리하여 데이터 가용성을 보장합니다. 클라이언트가 파일을 쓰거나 읽을 때, 가장 먼저 Master에게 "어디에 저장해야 하는가?" 또는 "어디에서 읽어야 하는가?"를 질의하게 됩니다.
Volume Server — 실제 데이터의 저장소
Volume Server는 물리적인 파일 데이터를 저장하는 워커 노드입니다. 여기서 SeaweedFS의 핵심 설계가 드러납니다. 일반적인 파일 시스템이 파일 하나당 하나의 OS 파일을 생성하는 것과 달리, SeaweedFS는 Facebook의 Haystack 논문에서 영감을 받은 구조를 사용합니다. 수많은 작은 파일들을 Needle이라는 단위로 직렬화하여, 하나의 거대한 물리적 파일인 Volume에 순차적으로 append합니다.
Filer — 메타데이터와 디렉토리 구조의 관리자
Filer는 사용자에게 익숙한 디렉토리 구조(/path/to/file)를 제공하는 메타데이터 계층입니다. 파일의 경로, 이름, 그리고 해당 데이터가 위치한 Volume ID 및 Offset 정보를 외부 저장소(본 시스템에서는 PostgreSQL)에서 관리합니다. Filer 덕분에 S3 호환 API나 POSIX-like 파일 경로를 통해 SeaweedFS에 접근할 수 있습니다.
이 세 컴포넌트의 상호작용을 정리하면 다음과 같습니다.
[파일 쓰기 흐름]
Client → Master Server: "파일을 어디에 저장할까요?"
Master Server → Client: "Volume 2에 저장하세요 (Volume Server A)"
Client → Volume Server A: 파일 데이터 전송
Volume Server A: Volume 2에 Needle로 append, Offset 기록
Client → Filer: "/production/tile_0001.glb → Volume 2, Offset 0x1A00" 메타데이터 등록
4.2 Haystack 구조: 왜 O(1) 조회가 가능한가
SeaweedFS가 대량의 작은 파일을 효율적으로 처리할 수 있는 비결은 Haystack 아키텍처에 있습니다.
전통적인 파일 시스템에서 10,000개의 작은 파일을 저장하면, OS는 10,000개의 inode와 디렉토리 엔트리를 관리해야 합니다. 파일 하나를 읽을 때마다 디렉토리 탐색 → inode 조회 → 데이터 블록 접근이라는 최소 3번의 디스크 I/O가 발생합니다. 파일 수가 많아질수록 메타데이터 자체가 디스크에 흩어져 성능이 급격히 저하됩니다.
SeaweedFS는 이 문제를 근본적으로 다른 방식으로 해결합니다.
저장 구조: Volume과 Needle

수천~수만 개의 작은 파일을 하나의 거대한 Volume 파일에 순차적으로 기록합니다. 각 파일은 Volume 내부에서 Needle이라는 단위로 관리되며, 각 Needle은 고유한 File ID(= Needle ID)와 Volume 내에서의 Offset, Size 정보를 가집니다.
조회 구조: In-Memory Index
Volume Server는 기동 시 각 Volume의 인덱스 데이터를 RAM에 로드합니다. 이 인덱스는 <Needle ID → (Offset, Size)>의 매핑 테이블입니다.
파일 조회 요청이 들어오면, Volume Server는 디스크를 탐색할 필요 없이 메모리에 올라와 있는 인덱스에서 Offset을 즉시 찾아내고, Volume 파일에서 해당 위치를 정확히 한 번의 디스크 I/O로 읽습니다. N개의 파일이 있어도 조회에 필요한 디스크 I/O는 항상 1번. 이것이 O(1) 성능의 핵심 원리입니다.
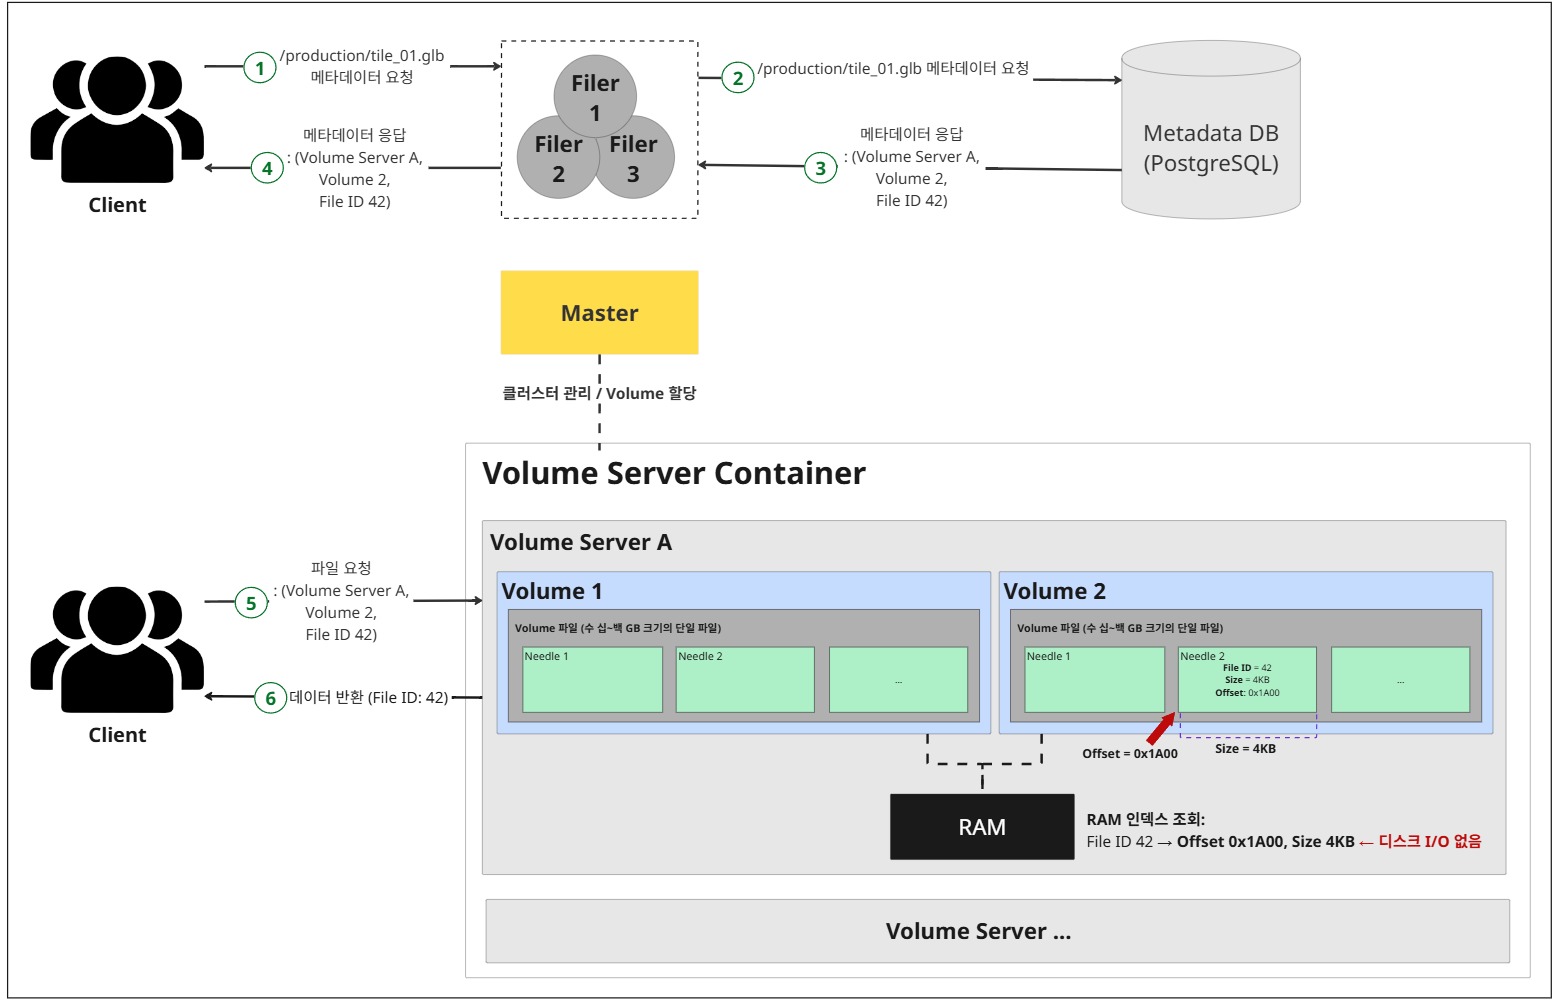
- Client → Filer: "/production/tile_01.glb 메타데이터 요청"
- Filer → PostgreSQL: "/production/tile_01.glb 메타데이터 조회"
- PostgreSQL → Filer: 메타데이터 응답 (Volume Server A, Volume 2, File ID 42)
- Filer → Client: 메타데이터 응답 (Volume Server A, Volume 2, File ID 42)
- Client → Volume Server A: "Volume 2, File ID 42 파일 요청"
Volume Server A 내부:- RAM 인덱스 조회: File ID 42 → Offset 0x1A00, Size 4KB ← 디스크 I/O 없음
- Volume 파일에서 Offset 0x1A00 위치를 seek → 4KB 읽기 ← 디스크 I/O 1회
- Volume Server A → Client: 데이터 반환 (File ID: 42)
4.3 물류 창고 비유로 이해하는 S3 vs SeaweedFS
이 아키텍처의 차이를 물류 창고에 비유하면 더 직관적으로 이해할 수 있습니다.
S3 방식 — 짐을 직접 옮기는 창고
물건의 위치를 바꾸려면 창고에 들어가서 무거운 짐을 실제로 들어, 다른 선반으로 옮겨야 합니다. 짐이 5,000개라면 5,000번 들었다 놓아야 합니다. 이것이 Copy & Delete입니다.
SeaweedFS 방식 — 명세서만 수정하는 창고
거대한 창고(Volume Server) 안의 짐은 그대로 둡니다. 사무실에 앉아서 화물 명세서(Filer/PostgreSQL)에 적힌 '보관 구역 번호'만 펜으로 수정합니다. 짐이 5,000개든 50,000개든, 명세서의 경로 정보 몇 줄만 고치면 됩니다. 물리적 이동은 제로입니다.
4.4 최종 시퀀스 다이어그램
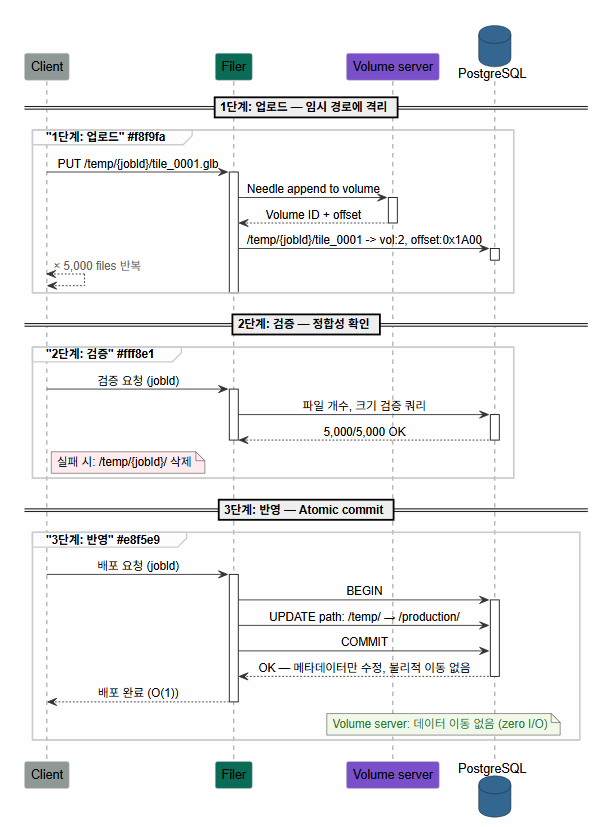
4.5 성능 개선 결과
SeaweedFS 아키텍처에서 Atomic Rename을 수행하면, Filer는 PostgreSQL 상의 파일 경로 매핑 정보만 수정합니다. Volume Server에 저장된 물리적 데이터 블록은 전혀 이동하지 않습니다.
- Latency: 수 GB 단위 파일 5,000개를 Rename하더라도, 실데 데이터를 옮기지 않기 때문에 수 KB 수준의 메타데이터 수정만 발생합니다. ms 단위로 처리가 완료됩니다.
- Consistency: 메타데이터 수정은 PostgreSQL 트랜잭션 안에서 원자적으로 수행됩니다. 네트워크 오류나 부분 실패 없이 완벽한 정합성을 보장합니다. Rename이 성공하면 모든 파일이 한꺼번에 보이고, 실패하면 아무것도 바뀌지 않습니다.
5. 요약
| 단계 | 내용 |
| 문제 | 대량 파일 업로드 시, I/O(스토리지)와 State(DB) 간의 트랜잭션 원자성 보장 필요 |
| 해결 | 임시 폴더에 업로드 후 일괄 Rename하는 Atomic Rename 패턴 적용 |
| 제약 | S3, MinIO 등 표준 오브젝트 스토리지의 물리적 복사(Copy-Delete) 오버헤드 |
| 최적화 | 메타데이터 기반 O(1) Rename을 지원하는 SeaweedFS(w/ PostgreSQL Filer) 아키텍처 채택 |
이 아키텍처를 통해 5,000개의 파일이 한 순간에 원자적으로 서비스에 반영되는 배포 파이프라인을 구축할 수 있었습니다.
핵심은 "데이터를 움직이지 말고, 데이터를 가리키는 포인터를 움직여라"는 단순한 원칙이었습니다.