PostgreSQL 내부 구조 (4) — VACUUM, 옛 버전은 누가 치우는가
PostgreSQL 내부 구조 시리즈
시작. 시리즈를 시작하며
0. 연결과 프로세스 구조
2. MVCC와 격리 수준
3. Locking
4. VACUUM
6. Index
8. TOAST
정리. 1~8편 총정리
2편(MVCC) 에서 본 것처럼 PostgreSQL은 옛 버전을 안 지운다. 시간이 지나면 어떤 트랜잭션도 더 이상 보지 않는 dead tuple이 쌓인다. 이걸 누가, 언제, 어떻게 치우는지 알아보자.
이 글에서 다루는 것:
- dead tuple, table bloat, VACUUM의 두 가지 역할 (페이지 회수 / freeze),
- Visibility Map (all-visible · all-frozen), autovacuum 트리거 조건과 튜닝, autovacuum cost 모델,
- 트랜잭션 ID wraparound (freeze), anti-wraparound vacuum,
- VACUUM vs VACUUM FULL
- 모니터링 (pg_stat_user_tables · datfrozenxid)
Dead Tuple이 만드는 문제
PostgreSQL은 UPDATE/DELETE 후 옛 버전은 페이지에 그대로 남는다.
시간이 지나 어떤 트랜잭션도 그 버전을 더 이상 볼 필요가 없으면, 그 튜플은 사실상 삭제 된 것과 같다. — dead tuple.
dead tuple은 그냥 거기 있는 것 자체로 비용이다.
- Seq Scan이 dead tuple도 다 훑는다. 가시성 판단으로 걸러내긴 하지만 읽기는 한다.
- 테이블 비대화(bloat): 살아 있는 행은 100만 개인데 페이지는 500만 개분이 차지하고 있는 상황. (dead tuple이 많아서)
- 인덱스에도 dead tuple을 가리키는 항목이 남는다. 인덱스 스캔이 가서 보면 죽은 행이라 무시되지만, 인덱스를 읽는 비용은 똑같이 든다.
pg_stat_user_tables로 현황을 볼 수 있다.
SELECT relname, n_live_tup, n_dead_tup,
       round(100.0 * n_dead_tup / NULLIF(n_live_tup + n_dead_tup, 0), 1) AS dead_pct,
       last_autovacuum
FROM pg_stat_user_tables
WHERE n_dead_tup > 0
ORDER BY n_dead_tup DESC
LIMIT 10;
dead_pct가 20%, 30%로 올라가면 슬슬 신경 써야 한다.
VACUUM 두 가지 역할
VACUUM의 역할은 두 가지다.
- Dead tuple 공간 회수. 더 이상 어떤 트랜잭션도 못 보는 튜플을 찾아서, 그 라인 포인터를 LP_DEAD → LP_UNUSED로 바꾼다(1편 참고). 페이지 안의 그 공간은 새 INSERT가 재사용할 수 있게 된다. 인덱스에서 그 ctid를 가리키던 항목도 같이 지운다
- 트랜잭션 ID wraparound 방지 (freeze). 트랜잭션 ID는 32비트라 약 42억 번이면 한 바퀴 돈다. 한 바퀴 돌면 옛 트랜잭션 ID가 미래의 트랜잭션 ID로 보이는 재앙이 일어난다. VACUUM은 충분히 오래된 튜플의 xmin을 특별한 상수 FrozenTransactionId로 교체한다. 이렇게 freeze된 튜플은 "모두에게 영원히 보임"으로 처리된다.
Visibility Map (VM) — VACUUM이 건너뛸 페이지를 표시
Vacuume을 위해 테이블 전체를 매번 훑는 건 너무 비싸다. PostgreSQL은 Visibility Map(VM) 으로 이 비용을 줄인다.
VM은 페이지당 2비트짜리 작은 비트맵이다.
| 비트 | 의미 |
| all-visible (bit=1) | 이 페이지의 모든 튜플이 모든 활성 트랜잭션에 보인다 (dead tuple 없음) |
| all-frozen (bit=0) | 이 페이지의 모든 튜플이 freeze됨 (wraparound 걱정 없음) |
여기서 "보인다(visible)"란 MVCC 가시성을 뜻한다.
예를 들어 트랜잭션 A가 행을 UPDATE했지만 아직 COMMIT하지 않았다면, 그 새 버전은 다른 트랜잭션 B에게는 "안 보인다." all-visible 페이지는 이런 미커밋 행이나 dead tuple이 하나도 없는, 누가 읽어도 전부 보이는 행들만 있는 페이지를 뜻한다.
VM의 목적 두 가지
- VACUUM이 건너뛸 페이지를 알려준다.
all-visible 비트가 켜진 페이지는 dead tuple이 없으니 VACUUM이 건너뛴다. all-frozen 비트가 켜진 페이지는 freeze도 건너뛴다. 수십 GB 테이블이라도 최근 변경된 페이지만 훑으면 되니 VACUUM 비용이 극적으로 줄어든다. - Index Only Scan이 힙(테이블)을 안 읽어도 되는지 알려준다.
PostgreSQL의 인덱스에는 가시성 정보(xmin, xmax)가 없다. 인덱스에서 원하는 행의 위치(ctid-(pageId, offset))를 찾았어도, 그 행이 현재 트랜잭션에 보이는지 확인하려면 힙까지 가서 튜플 헤더를 읽어야 한다. 그런데 VM에서 해당 페이지가 all-visible이면, 그 페이지의 모든 행은 확인 없이 보이는 게 보장된다. 힙 접근을 생략할 수 있고, 이게 Index Only Scan이 가능해지는 조건이다. (6편에서 다시 다룸)
페이지에 INSERT/UPDATE/DELETE가 일어나면 해당 비트가 꺼진다. 다음 VACUUM이 정리하고 나서야 다시 켜진다.
VM 파일 저장 경로
예시: C:\Program Files\PostgreSQL\17\data\base\{테이블 OID}.vm
Autovacuum — 알아서 도는 청소부
VACUUM을 사람이 직접 돌릴 필요는 거의 없다. PostgreSQL은 autovacuum 백그라운드 프로세스가 알아서 돌린다.
트리거 조건은 단순하다. 테이블의 dead tuple이 다음 임계치를 넘으면 autovacuum이 발동한다.
임계치 = autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor × n_live_tup
       =       50개 (기본 값)        +           0 .2 (기본 값)       × 살아있는 행
행이 100만 개인 테이블이면 dead tuple이 약 20만 개 쌓이면 autovacuum이 돈다. 이 기본 20%는 큰 테이블에서는 너무 느슨하다. 1억 행 테이블이면 2,000만 행이 dead가 될 때까지 안 도는 셈이니까. 큰 테이블은 테이블별로 더 공격적으로 설정하는 게 보통이다.
ALTER TABLE big_table SET (
  autovacuum_vacuum_scale_factor = 0.05,  -- 5%로 낮춤
  autovacuum_vacuum_threshold = 1000
);
autovacuum의 다른 주요 설정
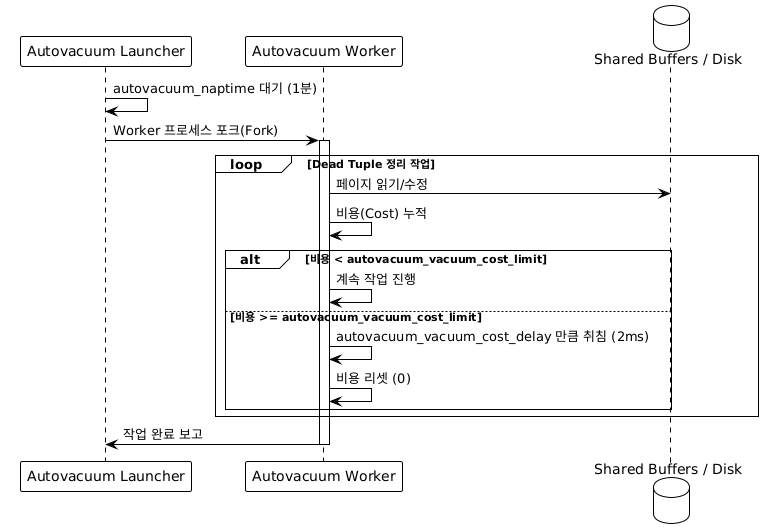
| 파라미터 | 역할 | 기본 값 |
| autovacuum_max_workers | 동시에 돌 수 있는 autovacuum worker 수 | 3 |
| autovacuum_naptime | autovacuum launcher가 깨어나는 주기 | 1분 |
| autovacuum_vacuum_cost_limit | 한 번에 쓸 수 있는 I/O 비용 한도 | 200 |
| autovacuum_vacuum_cost_delay | 비용 한도 도달 시 쉬는 시간 | 2ms |
autovacuum은 일부러 천천히(1분) 돈다. 운영 중인 시스템에 I/O 부담을 안 주려는 설계다. 그래서 dead tuple이 빠르게 쌓이는 워크로드에서는 autovacuum이 못 따라잡는 일이 생긴다. 그럴 땐 cost_limit를 올리거나(예: 2000) cost_delay를 줄여서 더 공격적으로 만든다.
가중치(Cost) 결정 파라미터
PostgreSQL은 페이지(8KB)를 처리할 때마다 다음 세 가지 설정값 중 하나를 누적합니다.
- vacuum_cost_page_hit (기본값: 1)
Shared Buffers(메모리)에서 페이지를 찾았을 때의 비용입니다. 메모리 접근이므로 가장 저렴합니다. - vacuum_cost_page_miss (기본값: 10)
Shared Buffers에 없어서 디스크에서 읽어왔을 때의 비용입니다. hit보다 10배 비쌉니다. - vacuum_cost_page_dirty (기본값: 20)
Vacuum이 Dead Tuple을 발견하고 해당 페이지를 '수정(Dirty)'했을 때 발생하는 비용입니다. 나중에 디스크에 다시 써야 하므로 가장 비쌉니다.
Cost = (메모리 히트 수 X vacuum_cost_page_hit ) +
(디스크 읽기 수 X vacuum_cost_page_miss) +
(페이지 수정 수 X vacuum_cost_page_dirty)
이 합계가 limit에 도달할 때마다 delay만큼 휴식
Freeze — 트랜잭션 ID가 한 바퀴 도는 문제
PostgreSQL의 트랜잭션 ID(XID)는 32비트 정수다. 약 42억 번이면 한 바퀴를 돈다. 문제는 MVCC의 가시성 판단이 XID의 대소 비교로 동작한다는 점이다.
2편에서 본 것처럼, "이 튜플의 xmin이 내 스냅샷보다 작으면 보인다"가 기본 규칙이다. 그런데 XID가 한 바퀴 돌면 어떻게 되나? 아주 오래 전에 커밋된 트랜잭션의 XID가 갑자기 "미래"처럼 보이게 된다. 그러면 이미 커밋된 데이터가 갑자기 안 보인다. 데이터가 사라지는 것과 같다.
| 파라미터 | 역할 | 기본 값 |
| vacuum_freeze_min_age | 이보다 오래된 xmin을 freeze | 5천만 |
| autovacuum_freeze_max_age | 테이블의 최고령 xmin이 이 나이가 되면 강제 vacuum | 2억 |
테이블의 가장 오래된 xmin이 autovacuum_freeze_max_age에 도달하면, 평소 autovacuum 트리거 조건과 무관하게 anti-wraparound vacuum이 돈다. 로그에 다음과 같이 찍힌다.
VACUUM의 freeze는 이 문제를 막는 작업이다. 충분히 오래된 튜플의 xmin을 특수한 값(FrozenTransactionId)으로 바꿔서 "이 튜플은 XID 비교와 상관없이 모든 트랜잭션에 항상 보인다"고 표시한다. 한번 freeze된 튜플은 XID가 몇 바퀴를 돌든 영향을 받지 않는다.
평소 autovacuum은 dead tuple 비율로 트리거되지만, freeze는 별도 조건이다. 테이블의 가장 오래된 xmin이 autovacuum_freeze_max_age(기본 2억)에 도달하면, dead tuple이 하나도 없어도 강제로 VACUUM이 돈다. 로그에 이렇게 찍힌다.
LOG: automatic vacuum of table "big_table" (to prevent wraparound): ...이건 막으면 안 된다. 만약 freeze가 계속 밀려서 XID 소진이 임박하면, PostgreSQL은 자기 보호를 위해 새 트랜잭션 자체를 거부한다.
ERROR: database is not accepting commands to avoid wraparound data loss이 상태가 되면 단일 사용자 모드로 들어가서 수동 VACUUM을 돌려야 한다.
all-frozen 비트 — freeze 비용을 줄이는 방법
PostgreSQL 9.6부터는 freeze 정보도 VM에 저장(all-frozen 비트)되어, 한 번 freeze된 페이지는 다음 anti-wraparound vacuum에서 다시 안 읽는다. 큰 테이블의 freeze 비용이 크게 줄었다.
한 번 freeze된 페이지는 Visibility Map에 all-frozen 비트가 켜진다. 다음 anti-wraparound VACUUM이 돌 때 이 비트가 켜진 페이지는 건너뛴다. 변경이 적은 큰 테이블일수록 효과가 크다 — 처음 한 번만 전체를 훑으면, 이후에는 새로 변경된 페이지만 처리하면 된다.
VACUUM FULL — 디스크를 진짜로 줄이고 싶을 때
일반 VACUUM은 빈 공간을 페이지 안에서 재사용만 한다.
만약 한 번에 대량 DELETE를 해서 디스크 자체를 줄이고 싶다면 VACUUM FULL을 써야 한다.
| 일반 | VACUUM | VACUUM FULL |
| 동작 방식 | 페이지 내 공간 정리 | 테이블을 새로 다시 씀 |
| 잠금 | ShareUpdateExclusiveLock (읽기/쓰기 동시 가능) | AccessExclusiveLock (모든 접근 차단) |
| 디스크 크기 | 줄어들지 않음 | 줄어듦 |
| 디스크 임시 사용량 | 거의 없음 | 테이블 크기만큼 추가 필요 |
| 인덱스 | 그대로 | 새로 빌드됨 |
운영 중인 테이블에 VACUUM FULL을 함부로 돌리면 안 된다. 테이블이 크면 시간이 오래 걸리고, 그동안 모든 쿼리가 막힌다. 다운타임 윈도우가 있을 때만 쓰거나, 대안으로 pg_repack 같은 확장을 쓴다 (온라인 재구성).
모니터링 — 어떻게 보는가
운영에서 신경 써야 하는 두 가지.
1. dead tuple 비율 — pg_stat_user_tables에서 dead_pct가 일정 수준(보통 20%) 이상으로 꾸준히 유지되면 autovacuum이 못 따라잡고 있다는 신호다.
2. wraparound (freeze)까지 남은 트랜잭션 수 — datfrozenxid로 데이터베이스의 가장 오래된 xmin과 현재 xid의 차이를 본다.
SELECT datname,
       age(datfrozenxid) AS xid_age,
       pg_size_pretty(pg_database_size(datname)) AS size
FROM pg_database
ORDER BY xid_age DESC;
xid_age가 10억(약 50%)을 넘기 시작하면 모니터링 해야 할 시점이다. 20억을 넘으면 위험 신호다.
다음 글에서는 WAL과 Checkpoint를 다룬다. dirty 페이지가 디스크에 쓰이는 그 메커니즘 — 1편에서 잠깐 언급한 "데이터를 쓰기 전에 로그를 먼저 쓴다" 매커니즘을 본다.