PostgreSQL 내부 구조 시리즈
시작. 시리즈를 시작하며
0. 연결과 프로세스 구조
2. MVCC와 격리 수준
3. Locking
4. VACUUM
6. Index
8. TOAST
정리. 1~8편 총정리
6편에서는 PostgreSQL의 인덱스가 Key와 ctid를 저장하고, ctid를 통해 실제 Heap Tuple을 찾아가는 과정을 살펴봤다.
하지만 인덱스가 존재한다고 해서 PostgreSQL이 항상 인덱스를 사용하는 것은 아니다.
CREATE INDEX idx_users_age ON users(age);

SELECT *
FROM users
WHERE age >= 20;
age에 인덱스가 있어도 실행 계획에서는 Sequential Scan이 선택될 수 있다.
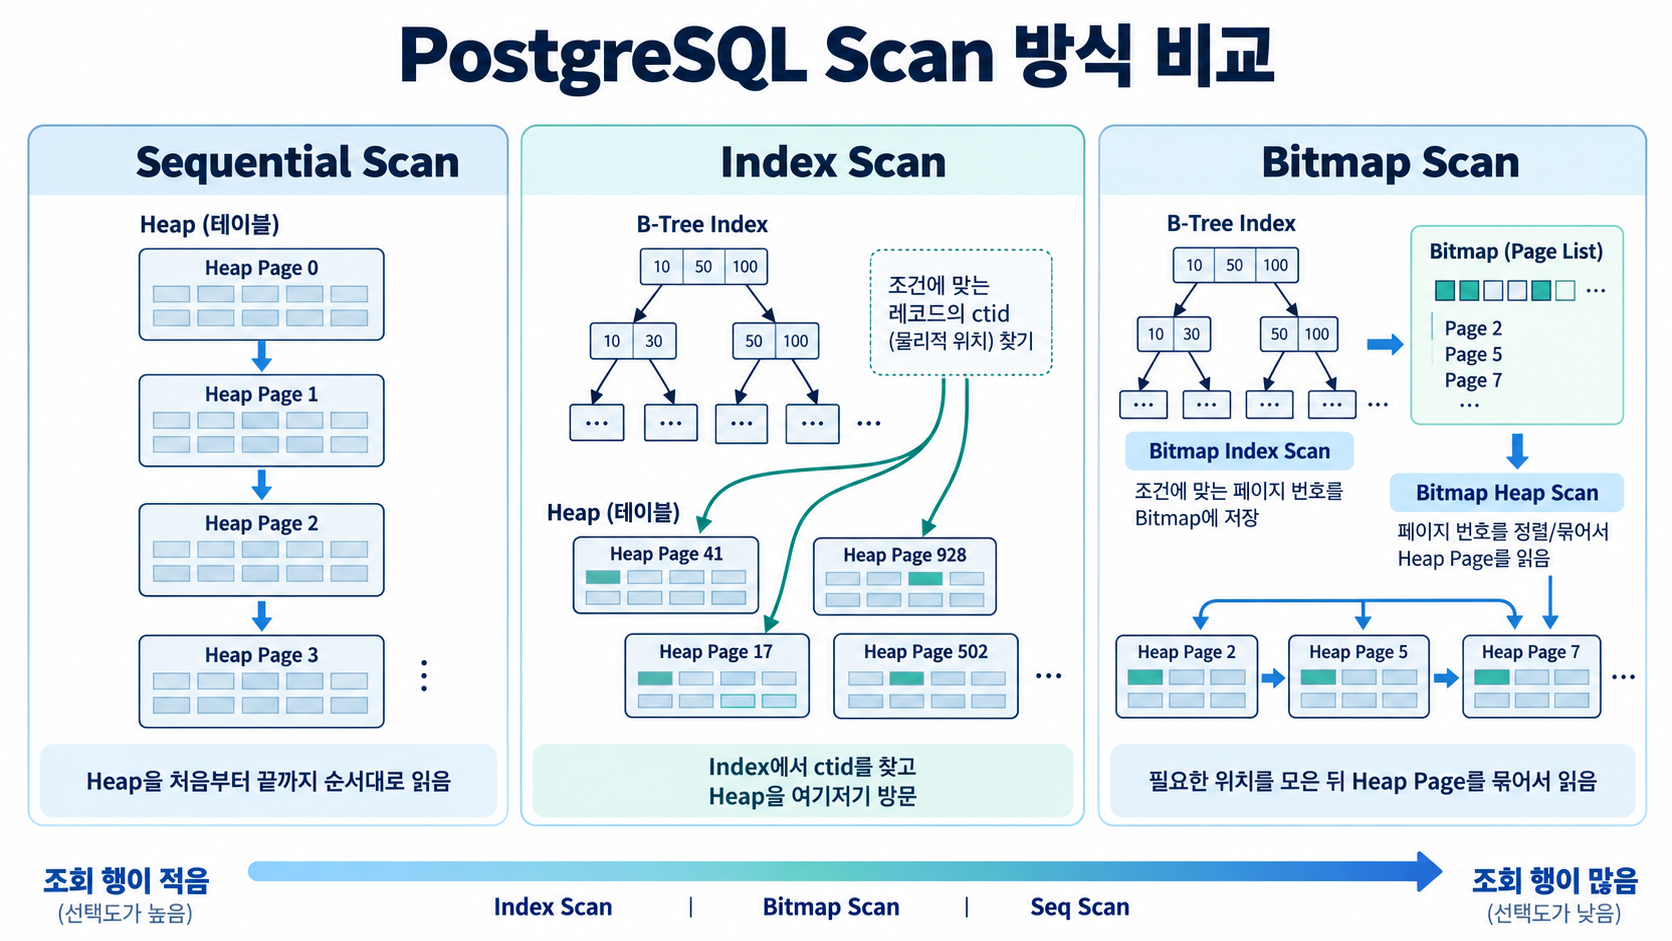
PostgreSQL은 테이블을 읽는 방법이 하나가 아니다. 조회할 데이터의 양과 조건에 따라 Sequential Scan, Index Scan, Index Only Scan, Bitmap Scan 같은 여러 방식 중 하나를 선택한다.
어떤 Scan을 사용할지는 인덱스의 존재 여부만으로 결정되지 않는다. Planner는 예상되는 Row 수와 데이터 분포, Heap 접근 비용 등을 바탕으로 여러 실행 방법의 Cost를 비교한다.
목차
- PostgreSQL의 Scan 방식
- Sequential Scan
- Index Scan
- Index Only Scan
- Bitmap Scan - Planner는 실행 계획을 어떻게 선택하는가
- Statistics와 Row Estimate
- Selectivity
- Cost - 인덱스가 있어도 Sequential Scan을 선택하는 이유
- EXPLAIN으로 Planner의 판단 확인하기
- Estimated Rows와 Actual Rows
- BUFFERS
- Extended Statistics - JOIN도 Planner가 선택한다
- Nested Loop
- Hash Join
- Merge Join
- JOIN 순서와 실행 Plan Tree
1. PostgreSQL의 Scan 방식
PostgreSQL이 Heap의 Tuple을 읽는 방법은 하나가 아니다.
전체 Table을 순서대로 읽을 수도 있고, Index를 따라 필요한 Tuple만 찾을 수도 있다. 조회 범위가 그 중간 정도라면 Index에서 필요한 위치를 먼저 모은 뒤 Heap Page를 묶어서 읽는 방법도 사용할 수 있다.
Sequential Scan
Sequential Scan은 Heap Page를 처음부터 끝까지 순서대로 읽는다.
Heap Page 0 → Page 1 → Page 2 → Page 3 → ...
다음처럼 테이블 전체가 필요한 쿼리에서는 가장 자연스러운 방식이다.
SELECT *
FROM users;
조건이 있다고 해서 반드시 Index를 사용하는 것은 아니다.
SELECT *
FROM users
WHERE age >= 20;
Sequential Scan이 선택되면 PostgreSQL은 Heap Page를 순서대로 읽으면서 각 Tuple에 조건을 적용한다.
테이블 전체를 읽어야 한다는 점만 보면 비효율적으로 보일 수 있지만, 실제 조회할 Row가 많다면 오히려 Sequential Scan이 더 저렴할 수 있다.
예를 들어 100만 행 중 80만 행을 가져와야 한다면 Index에서 80만 개의 위치를 찾고 Heap을 반복해서 방문하는 것보다 Heap을 순서대로 한 번 읽는 편이 유리할 수 있다.
Index Scan
Index Scan은 Index에서 조건에 맞는 Key를 찾고, 함께 저장된 ctid를 이용해 실제 Heap Tuple을 읽는다.
B-tree에서 Key 검색 → ctid 확인 → Heap Page 접근 → Tuple 확인
예를 들어 Index에서 id = 100을 검색해 ctid = (42, 3)을 찾았다면, Heap의 42번 Page에 있는 해당 Tuple로 이동할 수 있다.
6편에서 살펴본 일반적인 Index Entry는 Key와 ctid를 연결한다.
| Key | ctid |
| 100 | (42, 3) |
따라서 다음처럼 조회 대상이 매우 적을 때 Index Scan이 유리할 수 있다.
SELECT *
FROM users
WHERE id = 100;
다만 Index의 Key 순서와 Heap의 물리적인 Page 순서가 반드시 일치하는 것은 아니다.
예를 들어 연속된 Key가 서로 다른 Heap Page를 가리킬 수 있다.
| Index 순서 | Heap Page 위치 예시 |
| 1 | Heap Page 91 |
| 2 | Heap Page 14 |
| 3 | Heap Page 830 |
| 4 | Heap Page 7 |
조회 Row가 많아질수록 여러 Heap Page를 반복해서 방문하게 되고 Random Access 비용도 커질 수 있다.
Index Only Scan
쿼리에 필요한 값이 전부 Index에 있다면 Heap에서 실제 Row를 다시 읽지 않고 Index만으로 결과를 반환할 수도 있다.
CREATE INDEX idx_users_email
ON users(email);

SELECT email
FROM users
WHERE email = 'a@example.com';
하지만 PostgreSQL에서는 필요한 값이 Index에 모두 존재한다고 해서 항상 Heap 접근을 생략할 수 있는 것은 아니다.
이유는 MVCC Visibility를 확인해야 하기 때문이다.
현재 Transaction에서 해당 Tuple이 보이는지를 판단하는 정보는 Heap Tuple과 관련되어 있다. 이때 4편에서 살펴본 Visibility Map을 이용할 수 있다.
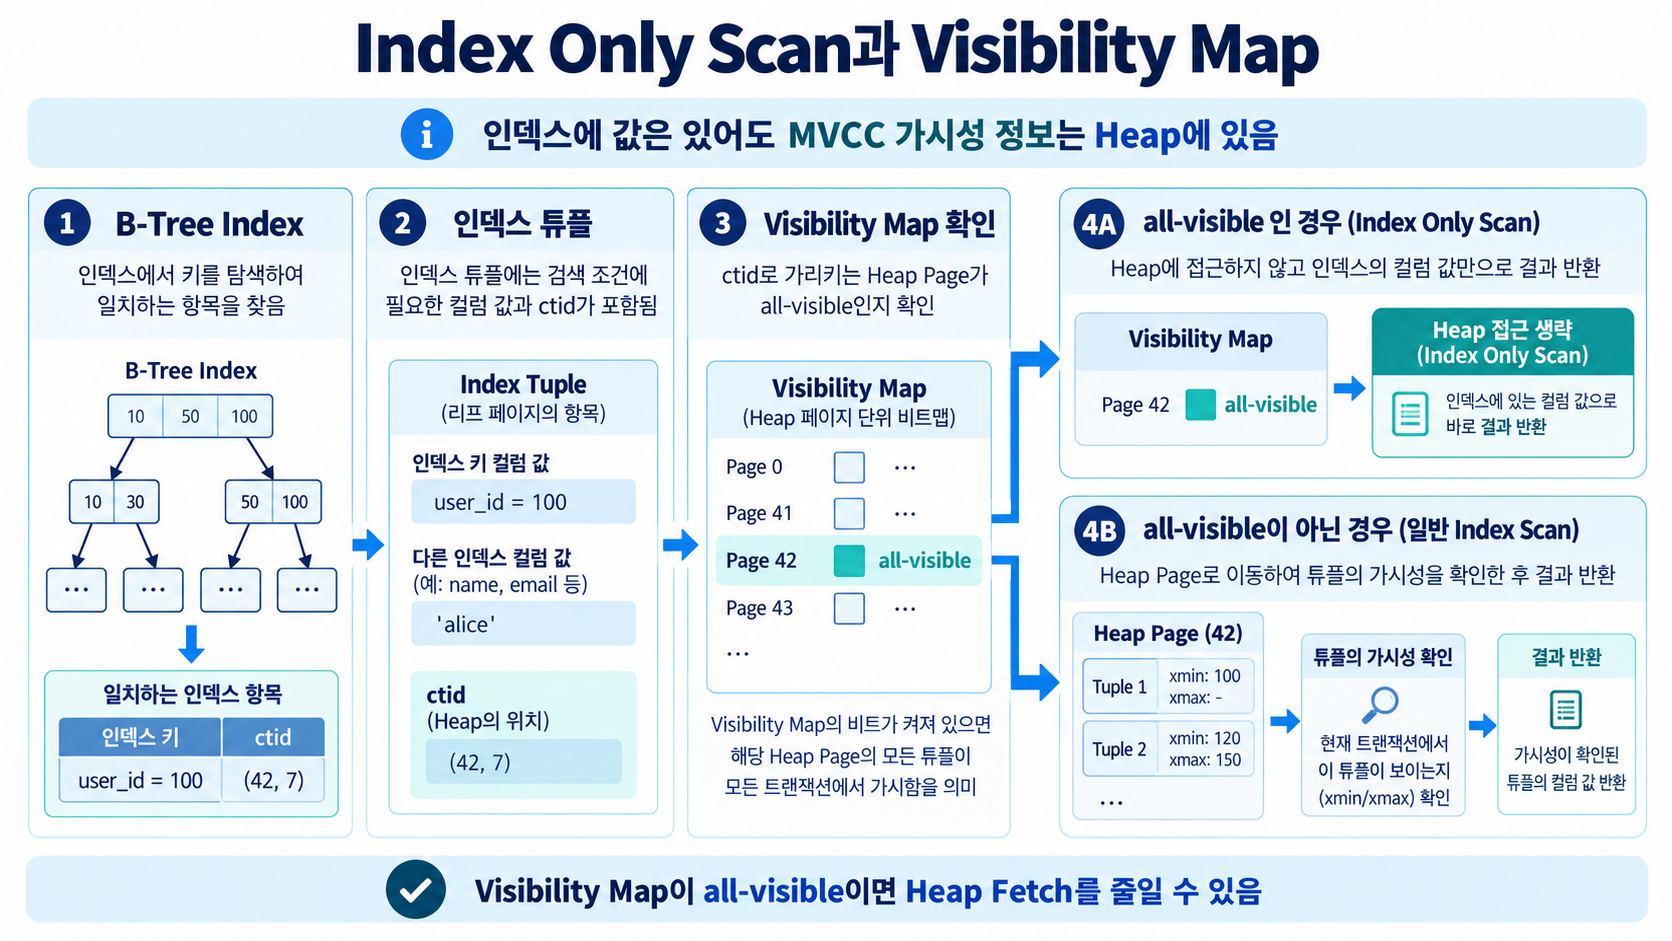
해당 Heap Page가 all-visible이라면 Heap Tuple의 Visibility를 다시 확인하기 위한 접근을 생략할 수 있다.
Index 확인 → Visibility Map 확인 → all-visible → Heap 접근 생략 가능
반대로 all-visible이 아니라면 Heap Page에 접근해 Visibility를 확인해야 한다.
그래서 EXPLAIN ANALYZE에서 Index Only Scan을 확인할 때는 다음 값도 함께 보는 것이 좋다.
Heap Fetches: 0
Heap Fetches가 작을수록 실제 Heap 접근을 많이 생략했다는 의미다.
VACUUM이 Visibility Map을 관리한다는 점에서 4편의 VACUUM을 알아야 한다.
Bitmap Scan
Sequential Scan과 Index Scan의 중간 성격을 가진 방법도 있다.
예를 들어 100만 행 중 5만 행 정도를 가져온다고 하자.
- Sequential Scan은 전체 Heap을 읽어야 하고, 일반적인 Index Scan은 조건에 맞는 많은 Tuple의 위치를 따라 Heap을 반복해서 방문해야 한다.
- Bitmap Scan은 먼저 Index에서 조건에 맞는 Tuple의 위치를 찾은 뒤, 필요한 Heap Page를 Bitmap으로 모아서 접근한다.
예를 들어 여러 Index Entry가 같은 Heap Page를 가리키고 있다면 해당 Page를 묶어서 처리할 수 있다.
Bitmap Index Scan → Bitmap 생성 → Bitmap Heap Scan
이를 통해 일반적인 Index Scan에서 같은 Heap Page를 여러 번 방문하면서 발생할 수 있는 비용을 줄일 수 있다.
Bitmap은 여러 Index의 검색 결과를 조합하는 데도 사용할 수 있다.
SELECT *
FROM users
WHERE age = 30
  AND city = 'Seoul';
예를 들어 age Index와 city Index의 검색 결과를 Bitmap으로 만든 뒤 BitmapAnd로 결합하고, 최종적으로 필요한 Heap Page를 읽는 실행 계획이 만들어질 수 있다.
결국 Scan 방식은 단순히 Index가 있으면 Index Scan, 없으면 Sequential Scan으로 결정되지 않는다.
조회할 Row 수와 데이터 분포, Heap 접근 비용 등 여러 조건에 따라 더 저렴한 방법이 선택된다.
2. Planner는 실행 계획을 어떻게 선택하는가
SQL이 들어왔다고 PostgreSQL이 바로 Table을 읽기 시작하는 것은 아니다.
Query를 분석한 뒤 Planner / Optimizer가 가능한 실행 방법을 비교하고 Execution Plan을 만든다.
SQL → Parser / Analyzer → Planner / Optimizer → Execution Plan → Executor
Planner는 하나의 쿼리에 대해 여러 실행 Path를 고려할 수 있다.
예를 들어 Table을 읽는 방법으로 Sequential Scan, Index Scan, Bitmap Scan 등이 있고, 여러 Table을 JOIN한다면 Nested Loop, Hash Join, Merge Join 같은 방법까지 함께 고려한다.
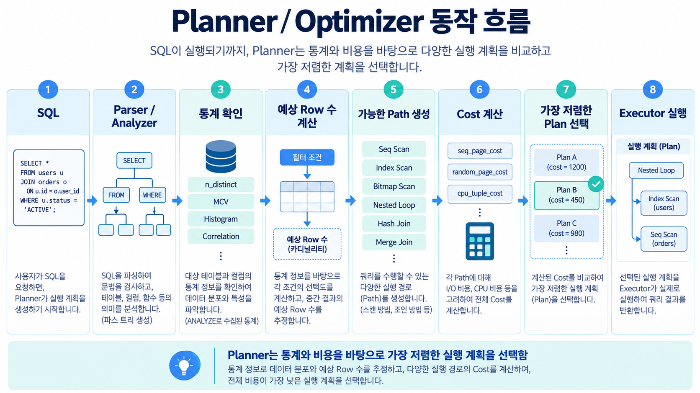
Planner는 각 Path의 Cost를 계산하고 가장 저렴하다고 판단한 Plan을 선택한다.
여기서 중요한 출발점은 조건에 맞는 Row가 몇 개나 나올지 예상하는 것이다.
Statistics와 Row Estimate
다음 쿼리를 예로 들어보자.
SELECT *
FROM users
WHERE country = 'KR';
- 전체 100만 행 중 country = 'KR'인 Row가 10개라면 Index를 사용하는 것이 유리할 수 있다.
- 반대로 90만 행이 KR이라면 Index를 따라 수많은 Heap Tuple에 접근하는 것보다 Sequential Scan이 더 저렴할 수 있다.
Planner는 실행 계획을 만들기 위해 실제 Query를 먼저 실행해 볼 수 없기 때문에 Table과 Column에 대한 통계 정보를 이용해 결과 Row 수를 추정한다.
PostgreSQL은 ANALYZE를 통해 이러한 통계를 수집한다.
ANALYZE users;
수집된 Column 통계는 pg_stats를 통해 확인할 수 있다.
SELECT
    attname,
    n_distinct,
    most_common_vals,
    most_common_freqs,
    histogram_bounds,
    correlation
FROM pg_stats
WHERE tablename = 'users';
대표적으로 다음과 같은 정보를 사용한다.
- n_distinct: 서로 다른 값이 얼마나 있는가
- most_common_vals: 자주 등장하는 값
- most_common_freqs: 자주 등장하는 값의 빈도
- histogram_bounds: 범위 조건을 추정하기 위한 값의 분포
- correlation: Column 값의 순서와 Heap의 물리적인 순서가 얼마나 유사한가
Selectivity
Planner는 통계 정보를 바탕으로 조건에 해당하는 비율인 Selectivity를 추정한다.
Selectivity ≈ 예상 결과 Row 수 / 전체 Row 수
이 값은 이후 예상 Row 수와 각 실행 Path의 Cost를 계산하는 데 사용된다.
Cost
EXPLAIN에서 Plan Node를 보면 다음과 같은 값을 확인할 수 있다.
cost = startup cost .. total cost
rows = 예상 Row 수
width = 예상 Row 크기
여기서 Cost는 실제 실행 시간을 의미하지 않는다.
cost = 1000
이라고 해서 실행 시간이 1000ms라는 뜻은 아니다.
Cost는 Planner가 여러 실행 방법을 서로 비교하기 위해 사용하는 상대적인 값이다.
대표적인 PostgreSQL 주요 Cost Parameter에는 다음과 같은 값이 있다.
| Cost Parameter | 의미 | 기본 값 (Postgres 18) |
| seq_page_cost | 디스크 Page를 순차적으로 읽는 비용 | 1.0 |
| random_page_cost | 디스크 Page를 임의 위치에서 읽는 비용 | 4.0 |
| cpu_tuple_cost | Row(Tuple) 하나를 처리하는 CPU 비용 | 0.01 |
| cpu_index_tuple_cost | Index Entry 하나를 처리하는 CPU 비용 | 0.005 |
| cpu_operator_cost | 비교, 연산자, 함수 같은 연산 1회를 수행하는 CPU 비용 | 0.0025 |
Planner는 Sequential Page Access와 Random Page Access, Tuple 처리, Index 처리 등의 비용을 조합해 각 실행 Path의 Cost를 계산한다.
3. 인덱스가 있어도 Sequential Scan을 선택하는 이유
앞의 예제를 다시 보자.
CREATE INDEX idx_users_age ON users(age);

SELECT *
FROM users
WHERE age >= 20;
Planner가 전체 100만 Row 중 약 85만 Row가 조건에 해당할 것이라고 예상했다고 하자.
Index Scan을 선택하면 Index에서 수십만 개의 Entry를 읽고, 각 Entry가 가리키는 Heap Tuple에도 접근해야 한다.
Index 탐색 → 약 850,000개의 Index Entry → 많은 Heap 접근
반면 Sequential Scan은 Heap Page를 처음부터 끝까지 순서대로 읽으면 된다.
따라서 Index가 존재하더라도 많은 Row를 조회하는 쿼리에서는 Sequential Scan의 Cost가 더 낮게 계산될 수 있다.
작은 Table에서도 비슷한 일이 발생할 수 있다.
Heap이 몇 Page밖에 되지 않는다면 B-tree를 탐색하고 ctid를 따라 Heap으로 이동하는 것보다 Heap Page 몇 장을 바로 읽는 편이 더 저렴할 수 있다.
즉 다음 두 가지는 같은 의미가 아니다.
인덱스가 존재한다 ≠ Index Scan이 선택된다
Planner는 Index가 존재하는지만 보는 것이 아니라 현재 Query에서 Index를 사용하는 것이 실제로 더 저렴한지를 판단한다.
4. EXPLAIN으로 Planner의 판단 확인하기
Planner가 선택한 Plan은 EXPLAIN으로 확인할 수 있다.
EXPLAIN
SELECT *
FROM users
WHERE id = 100;
예를 들어 다음과 같은 실행 계획이 나올 수 있다.
Index Scan using users_pkey on users
  (cost=0.42..8.44 rows=1 width=64)
EXPLAIN에 표시되는 Cost와 Rows는 Planner가 계산한 예상값이다.
실제 실행 결과와 비교하려면 EXPLAIN ANALYZE를 사용한다.
EXPLAIN ANALYZE
SELECT *
FROM users
WHERE id = 100;
그러면 Planner의 예상값뿐 아니라 실제 실행 시간과 실제 Row 수, 반복 횟수 등을 함께 확인할 수 있다.
(cost=...)
(actual time=... rows=... loops=...)
Estimated Rows와 Actual Rows
실행 계획을 분석할 때 특히 중요한 값 중 하나는 예상 Row 수와 실제 Row 수의 차이다.
Estimated Rows = 10
Actual Rows    = 300,000
Planner는 10 Row가 나올 것이라고 예상했지만 실제로 30만 Row가 나왔다면, 잘못된 Row Estimate를 기준으로 Scan이나 JOIN 방법을 선택했을 가능성이 있다.
부정확한 Statistics → 부정확한 Row Estimate → 부정확한 Cost → 비효율적인 Plan
따라서 Query가 느릴 때 무조건 Index를 추가하기보다 먼저 Planner가 어떤 전제를 바탕으로 실행 계획을 선택했는지 확인하는 편이 좋다.
BUFFERS
실제 Buffer 접근까지 확인하려면 다음처럼 사용할 수 있다.
EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM users
WHERE id = 100;
결과에서는 다음과 같은 Buffer 정보를 확인할 수 있다.
Buffers: shared hit=...
Buffers: shared read=...
shared hit은 필요한 Page가 Shared Buffers에 이미 있었다는 의미이고, shared read는 필요한 Page를 읽어 Shared Buffers로 가져왔다는 의미다.
(1편에서 살펴본 Shared Buffers가 실제 Query 실행 계획 분석과 다시 연결된다.)
Extended Statistics
여러 Column 사이의 관계 때문에 Row Estimate가 크게 틀리는 경우에는 Extended Statistics를 사용할 수도 있다.
CREATE STATISTICS address_stats
    (dependencies, mcv)
ON country, city
FROM address;

ANALYZE address;
enable_seqscan = off처럼 특정 Plan을 억제하는 설정도 있지만, 이런 설정은 다른 Plan과 비교하기 위한 진단 용도로 보는 편이 좋다.
문제의 원인이 부정확한 통계에 있다면 Scan 방식만 강제로 변경하더라도 근본적인 Row Estimate 문제는 그대로 남아 있다.
5. JOIN도 Planner가 선택한다
Table 하나를 읽을 때 Scan 방식을 선택하는 것처럼, 여러 Table을 연결할 때는 어떤 JOIN 방식을 사용할지도 Planner가 선택한다.
대표적으로 Nested Loop, Hash Join, Merge Join이 있다.
Nested Loop
Nested Loop는 Outer 입력의 각 Row마다 Inner 쪽에서 조건에 맞는 Row를 찾는다.
Outer Row 선택 → Inner 검색 → 다음 Outer Row → 다시 Inner 검색
Outer의 Row 수가 적고 Inner 쪽에 적절한 Index가 있다면 효율적일 수 있다.
반대로 Outer의 예상 Row 수가 크게 틀리면 Inner Scan이 예상보다 훨씬 많은 횟수로 반복될 수 있다.
Hash Join
Hash Join은 한쪽 입력을 이용해 Hash Table을 만들고, 다른 쪽 입력을 읽으면서 Join Key를 Hash Table에서 조회한다.
한쪽 입력 → Hash Table 생성 → 다른 쪽 입력 → Hash Lookup
많은 Row를 Equality 조건으로 JOIN할 때 자주 선택되는 방식이다.
Merge Join
Merge Join은 두 입력이 Join Key 순서로 정렬되어 있을 때 양쪽을 순서대로 읽으면서 같은 값을 찾는다.
Index를 이용해 이미 정렬된 결과를 얻을 수 있다면 별도의 Sort 없이 Merge Join에 사용할 수도 있다.
| 방식 | 기본 동작 | 유리한 상황 | Row Estimate가 틀렸을 때 영향 |
| Nested Loop | Outer의 각 Row마다 Inner에서 조건에 맞는 Row를 반복해서 찾는다 | Outer 결과가 적고 Inner에 적절한 Index가 있을 때 | Outer Row 수를 너무 적게 예상하면 Inner 탐색이 예상보다 훨씬 많이 반복될 수 있다 |
| Hash Join |
한쪽 입력으로 Hash Table을 만들고 다른 쪽 입력에서 Join Key를 Hash Lookup한다 |
많은 Row를 Equality 조건(=)으로 JOIN할 때 | Build 입력 크기를 잘못 예상하면 Hash Table의 메모리 사용량과 전체 Cost 추정이 크게 달라질 수 있다 |
| Merge Join |
Join Key로 정렬된 두 입력을 순서대로 읽으면서 같은 값을 찾는다 | 입력이 이미 정렬되어 있거나 정렬 비용을 감당할 수 있을 때 | Row 수나 중간 결과 크기를 잘못 예상하면 Sort 비용을 포함한 전체 Cost 판단이 부정확해질 수 있다 |
JOIN 순서와 실행 Plan Tree
Planner가 선택하는 것은 JOIN 알고리즘만이 아니다. 여러 Table을 어떤 순서로 JOIN할지도 실행 비용에 영향을 준다.
예를 들어 다음 두 구조는 결과는 같더라도 중간 결과의 크기가 달라질 수 있기 때문에 Cost가 서로 다를 수 있다.
(A JOIN B) JOIN C

A JOIN (B JOIN C)
결국 최종 실행 계획은 여러 Scan Node와 JOIN Node가 연결된 Tree 구조가 된다.
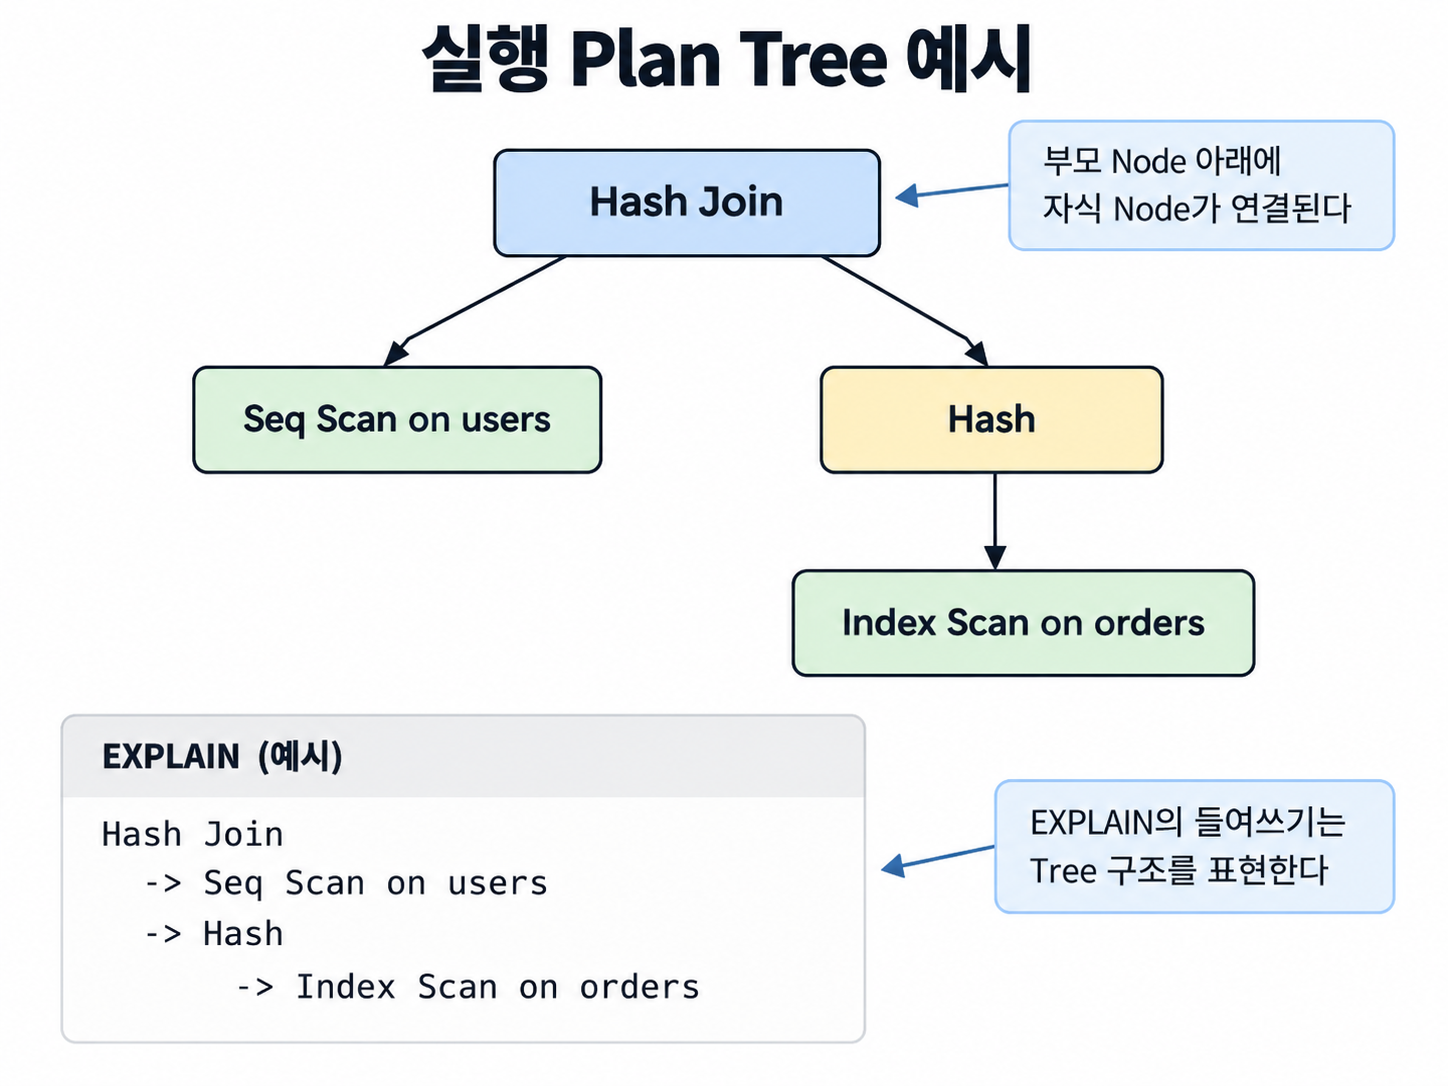
EXPLAIN에서 각 Node가 들여쓰기되어 표시되는 이유도 이 실행 Tree의 부모와 자식 관계를 보여주기 위해서다.
Planner의 전체 흐름을 다시 정리하면 다음과 같다.
SQL → 통계 확인 → 예상 Row 수 계산 → 가능한 Path 생성 → Cost 계산 → 가장 저렴한 Plan 선택 → Executor 실행
실행 계획을 볼 때는 단순히 Index를 사용하는지만 확인하기보다 다음을 함께 보는 것이 중요하다.
- 몇 Row가 나올 것이라고 예상했는가
- 실제로 몇 Row가 나왔는가
- 어떤 Scan과 JOIN을 선택했는가
- 어느 Node에서 시간이 많이 걸렸는가
- 실제 Buffer 접근은 얼마나 발생했는가
EXPLAIN ANALYZE는 PostgreSQL이 어떤 Plan을 선택했는지를 보는 것뿐 아니라, 그 선택의 전제가 실제 데이터와 얼마나 맞았는지를 확인하는 도구다.
다음 편에서는 다시 1편의 8KB Page로 돌아간다.
PostgreSQL의 Heap Tuple은 하나의 Page 안에 저장되어야 한다. 하지만 TEXT, JSONB, BYTEA 같은 가변 길이 데이터에는 하나의 Page보다 훨씬 큰 값이 들어갈 수 있다.
PostgreSQL이 이런 큰 값을 기존 Page 구조 안에서 어떻게 처리하는지 다음 편에서 TOAST를 통해 알아보자.
'데이터베이스 > PostgreSQL 내부 구조' 카테고리의 다른 글
| PostgreSQL 내부구조 1~8편 총정리 (0) | 2026.09.25 |
|---|---|
| PostgreSQL 내부구조 (8) ㅡ TOAST (0) | 2026.09.25 |
| PostgreSQL 내부구조 (6) ㅡ Index (0) | 2026.07.18 |
| PostgreSQL 내부 구조 (5) — WAL과 Checkpoint, 장애 복구의 핵심 (0) | 2026.04.18 |
| PostgreSQL 내부 구조 (4) — VACUUM, 옛 버전은 누가 치우는가 (0) | 2026.04.18 |
| PostgreSQL 내부 구조 (3) — Locking, 동시성의 또 다른 축 (1) | 2026.04.18 |
| PostgreSQL 내부 구조 (2) — MVCC와 격리 수준 (1) | 2026.04.18 |
| PostgreSQL 내부 구조 (1) — 페이지와 Shared Buffers (1) | 2026.04.18 |


